June 6, 2019

Les différents rôles : ADDS, ADFS, ADCS


Quand vous passerez à la mise en place d’un Active Directory, lors de l’installation, vous verrez qu’il y a cinq rôles qui comprennent la notion d’Active Directory. Cependant, un seul d’entre eux est la base de tout et permet de mettre en place les services d’annuaire Active Directory.

Ces cinq rôles permettent de répondre à des besoins différents, mais ils sont capables de fonctionner ensemble et de se « répartir les tâches », car ils sont conçus pour assumer un rôle bien spécifique.
Faisons le point sur ces différents rôles et leurs fonctionnalités.

I. ADDS – Active Directory Domain Services

Comme son nom l’indique, ADDS permet la mise en place des services de domaine Active Directory, autrement dit la mise en œuvre d’un domaine et d’un annuaire Active Directory.
Ce rôle permet de gérer au sein d’un annuaire les utilisateurs, les ordinateurs, les groupes, etc. afin de proposer l’ouverture de session via des mécanismes d’authentification et le contrôle d’accès aux ressources. Enfin, je ne vous apprends rien, car depuis le début de ce cours on parle précisément de ce rôle, mais maintenant vous savez qu’il correspond au rôle « ADDS » défini dans Windows Server.
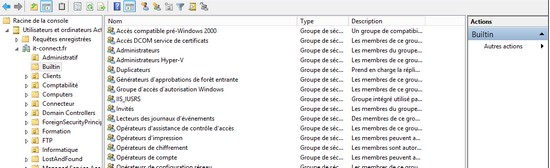
Console de gestion de l'Active Directory

II. ADCS - Active Directory Certificate Services

Ce rôle apporte une couche sécurité supplémentaire au sein du système d’information puisqu’il permet de gérer et de créer des clés ainsi que des certificats. Ce rôle est compatible avec de nombreuses applications, ce qui offre un intérêt supplémentaire à l’utiliser pour augmenter la sécurité de manière générale.
ADCS est composé de différents modules qui permettent d’effectuer des demandes de certificats de diverses façons : par le web, par le réseau, etc.

III. ADFS - Active Directory Federation Services

Depuis Windows Server 2008, un rôle nommé « ADFS » est disponible. Il s’agit d’un service de fédération qui permet de simplifier l’accès à des applications, que l’on se trouve ou non sur le même réseau.
Principalement, ADFS permet l’intégration d’un mécanisme SSO (Single Sign-On) c’est-à-dire l’authentification unique. Je m’explique. On se connecte sur le portail ADFS avec ses identifiants, et si l’authentification réussit on obtient directement l’accès à l’application cible sans devoir se réauthentifier.
Ainsi, les demandes d’authentification pour accéder aux applications sont centralisées et des jetons d’accès sont distribués aux clients, si l’accès est autorisé.
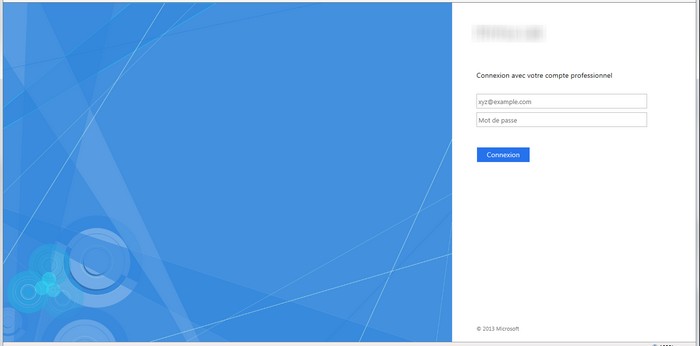
Exemple de portail ADFS

Bien sûr, ce rôle doit s’appuyer sur un annuaire Active Directory pour vérifier l’identité de l’utilisateur qui tente de se connecter.

IV. ADRMS - Active Directory Rights Management Services

Depuis Windows Server 2008 R2, le rôle ADRMS est directement intégré au système d’exploitation. Il permet de gérer finement les autorisations sur les fichiers des utilisateurs. Il ne se limite pas aux simples autorisations comme « accès en lecture » ou « accès en lecture et écriture », ce sont plutôt des droits comme : « J’autorise les utilisateurs à sauvegarder le fichier, mais je n’autorise pas l’impression du fichier ».
ADRMS est une application « client – serveur », cela implique qu’ADRMS s’intègre dans les applications pour créer de l’interaction. De ce fait, les applications doivent être compatibles, ce qui est le cas des versions de Microsoft Office Entreprise, Professional Plus et Integral.
Finalement, ADRMS augmente la sécurité de vos fichiers au niveau des accès, ce qui permet de mieux protéger l’information.

V. ADLDS - Active Directory Lightweight Directory Services

Historiquement appelé « ADAM » pour un Active Directory en mode application, le rôle ADLDS se rapproche du mode ADDS classique à la différence qu’il n’implique pas la création d’un domaine, mais fonctionne directement en mode instance, où plusieurs instances d’ADLDS peuvent être exécutées sur le serveur.
L’intérêt est de pouvoir créer un annuaire autonome qui permettra de créer une base d’utilisateurs, pouvant être utilisé dans le cadre d’un processus d’authentification auprès de l’annuaire LDAP. Par contre, ces utilisateurs ne peuvent pas être utilisés pour mettre en place du contrôle d’accès, car il n’y a pas cette notion de sécurité due à l’absence de contrôleur de domaine.
ADLDS peut être utilisé pour créer un magasin d’authentification avec une base d’utilisateurs (comme des clients ou des prestataires externes) pour accéder à un portail web extranet, par exemple.

Source

April 22, 2019

Qu'est-ce que l'approche CI/CD ?

L'approche CI/CD permet d'augmenter la fréquence de distribution des applications grâce à l'introduction de l'automatisation au niveau des étapes de développement des applications. Les principaux concepts liés à l'approche CI/CD sont l'intégration continue, la distribution continue et le déploiement continu. L'approche CI/CD représente une solution aux problèmes posés par l'intégration de nouveaux segments de code pour les équipes de développement et d'exploitation (ce qu'on appelle en anglais « integration hell », ou l'enfer de l'intégration).
Plus précisément, l'approche CI/CD garantit une automatisation et une surveillance continues tout au long du cycle de vie des applications, des phases d'intégration et de test jusqu'à la distribution et au déploiement. Ensemble, ces pratiques sont souvent désignées par l'expression « pipeline CI/CD » et elles reposent sur une collaboration agile entre les équipes de développement et d'exploitation.

Quelle est la différence entre CI et CD (et l'autre CD) ?

L'acronyme « CI/CD » a plusieurs significations. Le « CI » de CI/CD désigne toujours l'« intégration continue », à savoir un processus d'automatisation pour les développeurs. L'intégration continue consiste, pour les développeurs, à apporter régulièrement des modifications au code de leur application, à les tester, puis à les fusionner dans un référentiel partagé. Cette solution permet d'éviter de travailler en même temps sur un trop grand nombre d'éléments d'une application, qui pourraient entrer en conflit les uns avec les autres.
Le « CD » de CI/CD désigne la « distribution continue » et/ou le « déploiement continu », qui sont des concepts très proches, parfois utilisés de façon interchangeable. Les deux concepts concernent l'automatisation d'étapes plus avancées du pipeline, mais ils sont parfois dissociés pour illustrer le haut degré d'automatisation.
Dans le cadre de la distribution continue, généralement les modifications apportées par le développeur à une application sont automatiquement testées et téléchargées dans un référentiel (tel que GitHub ou un registre de conteneurs), où elles peuvent être déployées dans un environnement de production actif par l'équipe d'exploitation. Le processus de distribution continue permet de résoudre les problèmes de visibilité et de communication entre l'équipe de développement et l'équipe métier. Ainsi, son objectif consiste à simplifier au maximum le déploiement de nouveau code.
Le déploiement continu (l'autre signification possible de « CD ») peut désigner le transfert automatique des modifications du développeur depuis le référentiel vers l'environnement de production, où elles peuvent être utilisées par les clients. Ce processus permet de soulager les équipes d'exploitation surchargées par les tâches manuelles qui ralentissent la distribution des applications. Il repose sur la distribution continue et automatise l'étape suivante du pipeline.
L'expression « CI/CD » peut désigner soit uniquement les deux pratiques liées d'intégration continue et de distribution continue, soit les trois pratiques, c'est-à-dire l'intégration continue, la distribution continue et le déploiement continu. Pour compliquer encore les choses, il arrive que l'expression « distribution continue » englobe également le processus de déploiement continu.
En conclusion, mieux vaut ne pas trop s'attarder sur ces questions de sémantique. Il suffit de retenir que l'approche CI/CD se rapporte à un processus, souvent représenté sous forme de pipeline, qui consiste à introduire un haut degré d'automatisation et de surveillance continues dans le processus de développement des applications. La signification réelle de ces termes varie au cas par cas, selon le niveau d'automatisation du pipeline CI/CD. De nombreuses entreprises commencent par l'intégration continue, puis se mettent peu à peu à automatiser la distribution et le déploiement, par exemple dans le cadre du développement d'applications natives pour le cloud.

Intégration continue

Le concept de développement d'applications modernes consiste à faire travailler plusieurs développeurs simultanément sur différentes fonctions d'une même application. Toutefois, si une entreprise prévoit de fusionner tous ces morceaux de code source le même jour (le « merge day » ou « jour du fusionnement »), alors la tâche risque de s'avérer laborieuse et de nécessiter beaucoup de procédures manuelles et de temps. En effet, lorsqu'un développeur qui travaille seul apporte des modifications à une application, celles-ci peuvent entrer en conflit avec les différentes modifications apportées simultanément par d'autres développeurs.
L'intégration continue (CI) permet aux développeurs de fusionner plus fréquemment leurs modifications de code dans une « branche » partagée, ou un « tronc », parfois même tous les jours. Une fois que les modifications apportées par un développeur sont fusionnées, elles sont validées par la création automatique de l'application et l'exécution de différents niveaux de test automatisés (généralement des tests unitaires et d'intégration) qui permettent de vérifier que les modifications n'entraînent pas de dysfonctionnement au sein de l'application. En d'autres termes, il s'agit de tester absolument tout, des classes et fonctions jusqu'aux différents modules qui constituent l'application. En cas de détection d'un conflit entre le code existant et le nouveau code, le processus d'intégration continue permet de résoudre les dysfonctionnements plus facilement, plus rapidement et plus fréquemment.

Distribution continue

Après l'automatisation de la création et des tests unitaires et d'intégration dans le cadre de l'intégration continue, la distribution continue automatise la publication du code validé dans un référentiel. Aussi, pour garantir l'efficacité du processus de distribution continue, il faut d'abord introduire le processus d'intégration continue dans le pipeline de développement. La distribution continue permet de disposer d'une base de code toujours prête à être déployée dans un environnement de production.
Dans le cadre de la distribution continue, chaque étape (de la fusion des modifications de code jusqu'à la distribution des versions prêtes pour la production) implique l'automatisation des processus de test et de publication du code. À la fin de ce processus, l'équipe d'exploitation est en mesure de déployer facilement et rapidement une application dans un environnement de production.

Déploiement continu

L'étape finale d'un pipeline CI/CD mature est le déploiement continu. En complément du processus de distribution continue, qui automatise la publication d'une version prête pour la production dans un référentiel de code, le déploiement continu automatise le lancement d'une application dans un environnement de production. En l'absence de passerelle manuelle entre la production et l'étape précédente du pipeline, le déploiement continu dépend surtout de la conception de l'automatisation des processus de test.
Dans la pratique, dans le cadre du déploiement continu, une modification apportée par un développeur à une application pourrait être publiée quelques minutes seulement après la rédaction du code en question (en supposant qu'elle passe les tests automatisés). Il est ainsi beaucoup plus facile de recevoir et d'intégrer en continu les commentaires des utilisateurs. Ensemble, ces trois pratiques CI/CD réduisent les risques liés au déploiement des applications, puisqu'il est plus simple de publier des modifications par petites touches qu'en un seul bloc. Cette approche nécessite néanmoins un investissement de départ considérable, car les tests automatisés devront être rédigés de manière à s'adapter à un large éventail d'étapes de test et de lancement dans le pipeline CI/CD.


April 7, 2019

Installing Docker

In this lesson, we'll install the latest version of Docker CE. The commands used throughtout this video are below.

Prerequisites

Uninstall old versions:
sudo yum remove -y docker \
                  docker-client \
                  docker-client-latest \
                  docker-common \
                  docker-latest \
                  docker-latest-logrotate \
                  docker-logrotate \
                  docker-engine

Install Docker CE

Add the Utilities needed for Docker:
sudo yum install -y yum-utils \
  device-mapper-persistent-data \
  lvm2
Set up the stable repository:
sudo yum-config-manager \
    --add-repo \
    https://download.docker.com/linux/centos/docker-ce.repo
Install Docker CE:
sudo yum -y install docker-ce
Enable and start Docker:
sudo systemctl start docker && sudo systemctl enable docker
Add cloud_user to the docker group:
sudo usermod -aG docker cloud_user

Source - Linux Academy

Magnum - OpenStack

Magnum is an OpenStack API service developed by the OpenStack Containers Team making container orchestration engines such as Docker Swarm, Kubernetes, and Apache Mesos available as first class resources in OpenStack. Magnum uses Heat to orchestrate an OS image which contains Docker and Kubernetes and runs that image in either virtual machines or bare metal in a cluster configuration. Click below for a ~2 minute demo of how the Magnum CLI works.
Demo-Preview-Frame.png

Getting Started / Download

To get started with Magnum, see: Our Quickstart Guide
Downloads:

Contributing

The project is under active development by our OpenStack Containers Team. We meet weekly by IRC.

Architecture

Magnum Architeture Diagram
Cluster Create/Update/Delete

Resources

IRC and IRC Meetings

Our developers use IRC in #openstack-containers on freenode for development discussion.

Users

  • CERN - details on the blog
  • (your group or organization here)

Frequently Asked Questions

1) How is Magnum is different from Nova?
Magnum provides a purpose built API to manage application containers orchestration engines, which have a distinctly different life cycle and operations than Nova (machine) Instances. We actually use Nova instances to compose our Clusters.
2) How is Magnum different than Docker or Kubernetes?
Magnum offers an asynchronous API that's compatible with Keystone, and a complete multi-tenancy implementation. It does not perform orchestration internally, and instead relies on OpenStack Orchestration. Magnum does leverage both Kubernetes and Docker as components.
3) Is this the same thing as Nova-Docker?
No, Nova-Docker is a virt driver for Nova that allows containers to be created as Nova instances. This is suitable for use cases when you want to treat a container like a lightweight machine. Magnum provides container orchestration engine management that is beyond the scope of Nova's API, and implements its own API to surface these features in a way that is consistent with other OpenStack services. Containers started on Magnum Clusters are run on top of Nova instances that are created using Heat.
4) Who is Magnum for?
Magnum is for OpenStack cloud operators (public or private) who want to offer a self-service solution to provide a hosted containers service to their cloud users. Magnum simplifies the required integration with OpenStack, and allows for cloud users who can already launch cloud resources such as Nova Instances, Cinder Volumes, Trove Databases, etc. to also create container clusters (Clusters) to run applications in an environment that provides advanced features that are beyond the scope of existing cloud resources.
5) Will I get the same thing if I use the Docker resource in Heat?
No, the Docker Heat resource does not provide a resource scheduler, or a choice of container technology used. It is specific to Docker, and uses Glance to store container images. It does not currently allow for layered image features, which can cause containers to take longer to start than if layered images are used with a locally cached base image. Magnum leverages all of the speed benefits that Docker offers, and implements Kubernetes and Mesos as alternate choices to Docker Swarm for container orchestration.
6) What does multi-tenancy mean in Magnum (Is Magnum Secure)?
Resources such as Clusters are started by Magnum can only be viewed and accessed by users of the tenant that created them. Clusters are not shared, meaning that containers will not run on the same kernel as neighboring tenants. This is a key security feature that allows containers belonging to the same tenant to be tightly packed within the same Pods and Clusters, but runs separate kernels (in separate Nova Instances) between different tenants. This is different than using a system like Kubernetes without Magnum, which was originally designed to be used only by a single tenant, and leaves the security isolation design up to the implementer. Using Magnum provides the same level of security isolation as Nova provides when running Virtual Machines belonging to different tenants on the same compute nodes.

Zun Installation Guide

How to Install Docker CE on CentOS 8 and RHEL 8

  Docker  is a daemon-based container engine which allows us to deploy applications inside containers.  Docker is available in two versions,...